Чешские имена часто содержат символы, которые не встречаются в английском алфавите: Ř, Š, č, ě, ů. Если клиент получил письмо «Dobrý den» или видит вместо имени знак замены, проблема может возникнуть в экспорте CRM, импорте в ESP, шаблоне письма или кодировке заголовков. Простая замена Řehoř на Rehor не является исправлением: она искажает имя клиента и скрывает источник технической ошибки.
Разделите цепочку обработки данных
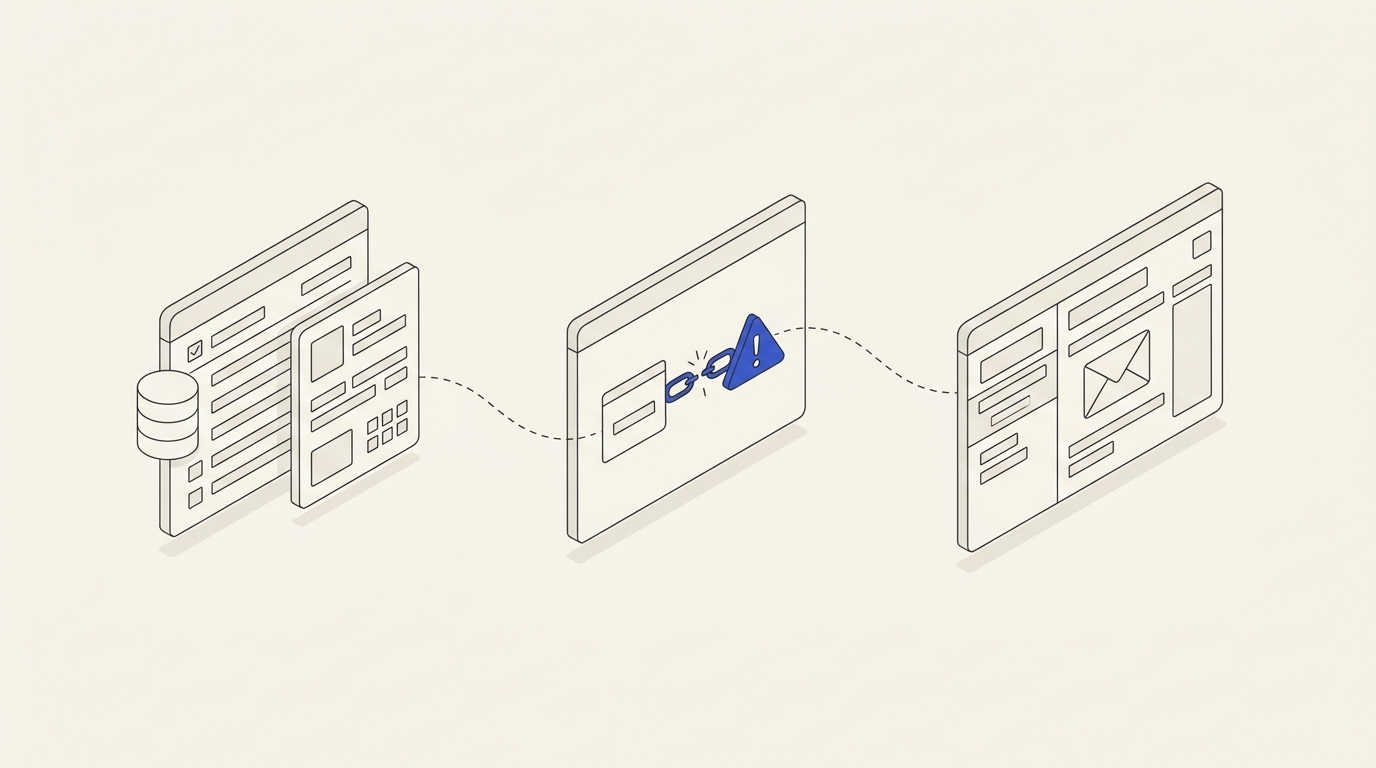
Один и тот же контакт проходит несколько стадий: исходная база CRM, экспорт CSV/API, импорт в ESP, поле персонализации, шаблон HTML, текстовая версия и почтовые заголовки. На каждой границе сохраните контрольное значение и сравните его посимвольно. Так можно отличить испорченный исходник от ошибки рендеринга. Если имя испорчено уже в CRM, смена шаблона не поможет.
Для системной диагностики рассылки пригодится настройка email-маркетинга; работа должна включать контрольные контакты и результаты доставки в несколько почтовых клиентов, а не только визуальный редактор ESP.
Для поиска сбоя по цепочке CRM → письмо полезен разбор кодировки и подстановки полей в реальном отправленном сообщении. Важно проверить и текстовую альтернативу HTML-письма: исправленная версия шаблона не гарантирует, что другая MIME-часть содержит те же имена и условия.
Что именно проверять в кодировке
Убедитесь, что экспортируемый файл действительно записан в UTF-8 и импортёр правильно его распознаёт. Открытие CSV в табличной программе может перекодировать его при повторном сохранении. Если используется API, проверьте передаваемую строку и JSON на уровне байтов и логов без публикации персональных данных. Не полагайтесь исключительно на надпись «UTF-8» в настройке, если сам файл уже был повреждён.
В HTML письма важны корректный набор символов и исходные данные переменных. У plain-text версии текст должен оставаться читаемым отдельно от HTML. Заголовок Subject технически кодируется по правилам почтового формата и может портиться независимо от тела. Разные почтовые клиенты способны проявлять ошибки по-разному, поэтому нужен тест на фактических полученных письмах.
Условный тест двух чешских контактов
Предположим, CRM содержит контакт C-17 «Řehoř Novák» и C-18 «Šárka Dvořáková». Экспорт в CSV хранит оба имени корректно в UTF-8. После импорта в ESP поле first_name у C-17 содержит знак �, а у C-18 имя осталось целым. Тема тестового письма у C-18 отображается корректно. Это учебный пример, не реальные персональные данные.
- Сохраните исходный CSV и его контрольную копию. Проверяйте значение C-17 в байтовом представлении и в редакторе, не пересохраняя файл по умолчанию.
- Импортируйте два тестовых контакта в отдельную группу без запуска рекламных автоматизаций. Сравните поля после импорта; ошибка C-17 подтверждает проблему до шаблона.
- Отправьте три теста: тема с «Řehoř», HTML с «Šárka» и plain-text с «Dvořáková». Просмотрите реально полученные письма и оригинальные заголовки.
- Исправьте найденный этап — настройки экспорта, кодировку файла, преобразование API или шаблон — и повторите тест на обоих контактах.
- После успешного теста определите безопасный процесс исправления уже повреждённых записей по исходной CRM, сохранив историю и исключив автоматическую транслитерацию.
Негативный тест: дизайнер заменил все символы с диакритикой латиницей и тестовое письмо стало «читаемым». Это не приёмка: исходные имена искажены. Другой отказ — HTML отображает всё правильно, а plain-text или Subject всё ещё повреждены.
Если и на сайте, и в письмах чешские буквы выглядят неправильно, отдельно исключите отсутствие чешских глифов у веб-шрифта. Это другая неисправность, а не способ исправить повреждённые байты имени в CRM; сравните исходные значения до смены типографики.
Как предотвратить повтор ошибки
Добавьте небольшой набор обязательных тестовых строк с чешскими буквами, кавычками, длинным тире и символами валюты. Проверяйте их после изменения CRM-коннектора, ESP, шаблона и маршрута импорта. Если проблема зависит от Excel/CSV, зафиксируйте конкретный допустимый формат выгрузки и ответственную программу.
При совместной работе CRM и сайта иногда нужно менять источник экспорта и форму записи имени, что относится к технической интеграции, а не только к дизайну письма. Для нескольких языков важно сохранить правильное обращение в соответствующем шаблоне, а не создавать одну транслитерированную базу для всех рынков.
Смета и приёмка
Объём зависит от количества источников, импортных форматов, шаблонов, языков и числа повреждённых записей. Результат — карта происхождения ошибки, тестовый набор символов, исправленный импорт, корректные Subject/HTML/plain text и план безопасного восстановления базы.
Восстановление повреждённых имён: где находится оригинал
Если вместо буквы уже сохранён символ замены �, простое переключение кодировки не восстановит исходный знак: необходим неповреждённый источник. Для условного C-17 сравните исходную CRM, сохранённый CSV, данные ESP и полученное письмо. Если ошибка присутствует уже в CRM, чинить шаблон бессмысленно; если CRM и файл корректны, а ESP нет, проверяйте импорт или API-трансформацию. В журнале отмечайте точную границу первого появления искажения и версию коннектора.
Исправление следует выполнять по отдельной подтверждённой карте контактов, а не массовой заменой всех похожих букв. После обновления C-17 и C-18 снова отправьте письмо с Subject, HTML и plain-text, сохранив оригинал полученного сообщения для сравнения. Если визуально всё выглядит правильно в одном клиенте, это ещё не доказывает корректность MIME-заголовка и резервной текстовой части в других условиях просмотра.
Пришлите через контакты пример обезличенной строки CSV и исходник тестового письма; это позволит оценить именно повреждённый участок цепочки.